让仿真用户检验智能体产出,要证据而不是模型结论
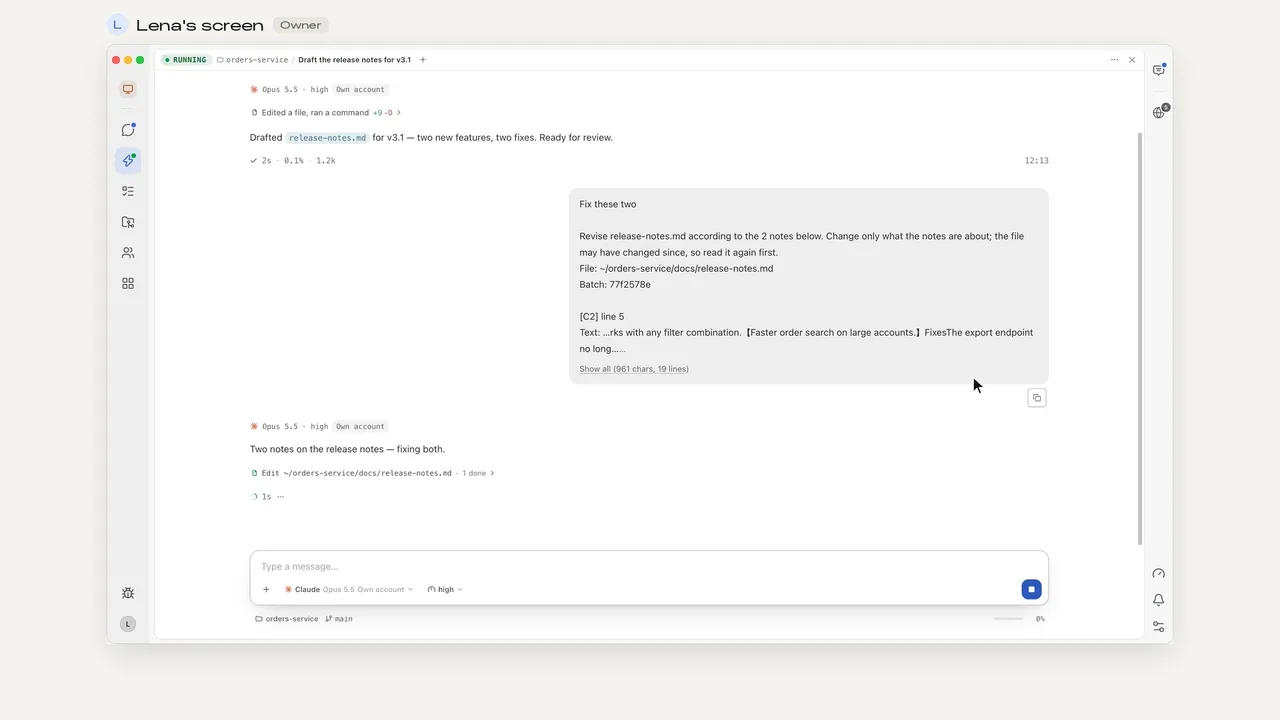
让智能体评审自己的产出,它评的只是代码改动。而你真正需要知道的是:一个人能不能完成任务——这得有人真把智能体做出来的东西用一遍才有答案。
智能体的自我评审为什么不够用
智能体评审自己的代码
有人去用智能体做出的东西
重点检验什么内容
代码改动:能否通过编译、命名是否一致、边界情况是否已处理
用户在实际使用中能不能顺利把整件事做完
用什么方式去检验
智能体直接阅读并检查修改后的代码
实际运行并操作智能体刚做出来的真实构建版本
能回答什么问题
这次修改的代码本身写得对不对
哪一步没人走得通、哪句话没人看懂、哪个按钮没人找得到
如果你问智能体它刚改的代码好不好,你会得到一份像样的代码改动评审,告诉你代码能编译、命名一致、边界情况也处理了;这些都没错,但没有一条回答了「这东西到底好不好用」。在开发早期,真正要紧的问题比代码评审直观得多:哪一步没人走得通、哪句话没人看得懂、哪个按钮没人找得到。只要有人把做出来的东西真正用上一遍,这些问题在几分钟内就会暴露出来,不至于拖上好几周、等投入沉没之后才被发现。
仿真用户评测跑起来是什么样
- 你调用 $eval 发起评测
评测是你按需手动触发的显式技能,不是常开的自动评审
- 仿真用户试用真实构建版本
仿真在本机运行,直接操作智能体刚做出来的真实构建产物
- 评测返回实际使用证据
截图、执行轨迹、命令记录和评测报告都会收进产物面板
- 证据锚定到对应的那次运行
绑定产出它的机器与运行记录,可在对应会话旁直接预览
这张流程图说明,调用 $eval 拿回的是绑定到具体运行的证据而非打分;追溯不到某次运行的结论,一律视为没有结论。
评测证据如何接入下一步工作
- 保存第一轮评测的证据
评测证据会一直保存在它所属的项目里,不会丢失
- 评测证据直接变成下一批任务
仿真用户没走通的步骤直接转为待办任务,不用人工重新录工单
- 智能体针对暴露的问题做修复
- 再跑第二轮仿真用户评测
拿第二轮结果与第一轮对比来验证修复效果,而不是覆盖旧记录
这张图展示了评测闭环:发现的问题不用人重敲成工单就能交给智能体修复,且第一轮证据还在,「修复有没有生效」才答得上来。
当然,仿真用户不是真实用户的替代品,这套评测也不宣称能预测你的真实客户会怎么做。它提供的是一种快速、可重复的检验方式,帮你在上线前找出那些事后看很明显、真发出去会让人难堪、但不做这步实测就真的会发出去的问题。